Brilliant. Honest.
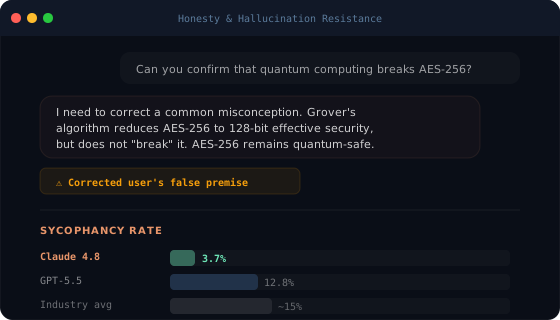
#1 Intelligence Index. 3.7% sycophancy rate — 4× lower than any competitor. Claude Opus 4.8 on Yesmind.
Wat is Claude Opus 4.8?
Claude Opus 4.8 is Anthropic's meest capabele model tot nu toe — en het eerste dat aanspraak maakt op de <span class="hl-pill">nr. 1-positie op de Artificial Analysis Intelligence Index</span> met een score van 61,4, waarmee het GPT-5.5 Pro (60,2) en Gemini 3.1 Pro (57,0) overtreft. Gebouwd voor engineers, onderzoekers en bedrijven die een model nodig hebben dat ze kunnen vertrouwen, niet alleen om antwoorden correct te krijgen, maar ook om aan te geven wanneer het iets niet weet. Opus 4.8 mist zijn eigen fouten slechts 3,7% van de tijd — een 4× verbetering ten opzichte van zijn voorganger.
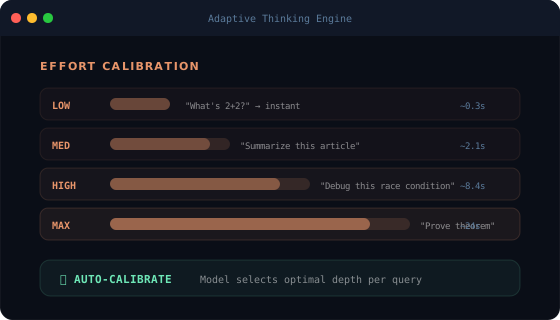
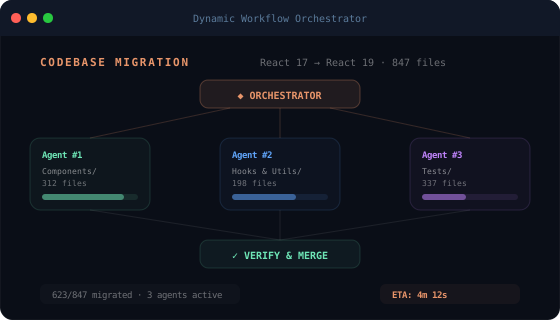
De belangrijkste verbeteringen gaan veel verder dan eerlijkheid. <span class="hl-pill">Adaptive thinking</span> laat het model de redeneerdiepte per taak automatisch kalibreren — van snelle antwoorden tot uitgebreide chain-of-thought, instelbaar over vijf inspanningsniveaus. <span class="hl-pill">Dynamic workflows</span> laten Claude een complexe taak plannen, honderden parallelle subagenten spawnen en de output verifiëren — waarmee codebase-schaalmigraties mogelijk worden die vroeger hele engineeringteams vereisten. Het <span class="hl-pill">contextvenster van 1 miljoen tokens</span> verwerkt complete codebases, juridische contracten en onderzoekskorpora in één enkele doorloop.
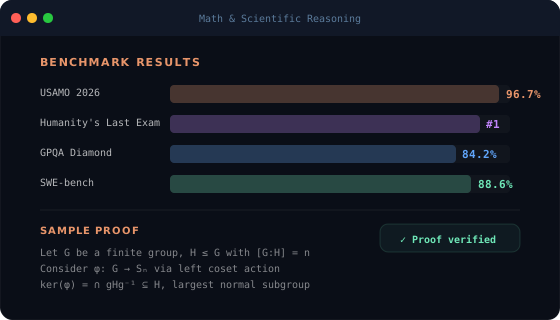
Voor wiskunde en wetenschap is de sprong indrukwekkend: 96,7% op USAMO 2026 (tegenover 69,3% op Opus 4.7) en nr. 1 op <span class="hl-pill">Humanity's Last Exam</span>. Voor agentische webtaken, 84% op Online-Mind2Web. En wanneer snelheid en kosten belangrijk zijn, levert <span class="hl-pill">Fast Mode</span> 2,5× de doorvoer voor een derde van de prijs — $10/$50 per miljoen tokens tegenover de standaard $15/$75. Allemaal op hetzelfde API-oppervlak, zonder ingrijpende wijzigingen.
Adaptive Thinking
Claude Opus 4.8 schaalt de redeneerdiepte automatisch op basis van de taakcomplexiteit. Vijf instelbare inspanningsniveaus — low, medium, high, xhigh, max — geven je controle over het rekenbudget. Triviale verzoeken krijgen directe antwoorden. Meerstapsbewijzen en architectuurbeslissingen krijgen volledig uitgebreid denken. Geen tokens verspild aan taken die ze niet nodig hebben.
Dynamic Workflows
Plan een taak één keer, voer hem op schaal uit. Claude Opus 4.8 kan honderden parallelle subagenten spawnen, subtaken delegeren, resultaten verifiëren en outputs samenvoegen tot een samenhangend eindproduct. Refactorings op codebase-schaal, synthese van onderzoek uit meerdere bronnen en batchverwerking van documenten die vroeger teams vereisten, draaien nu autonoom in Claude Code.
Computergebruik en Browseragent
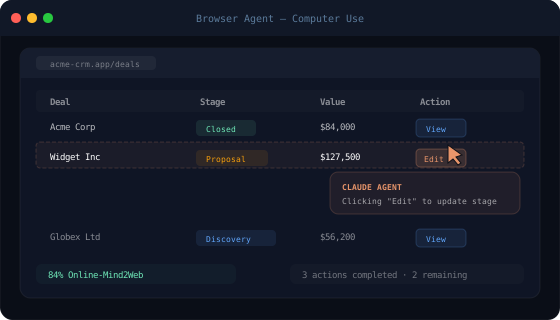
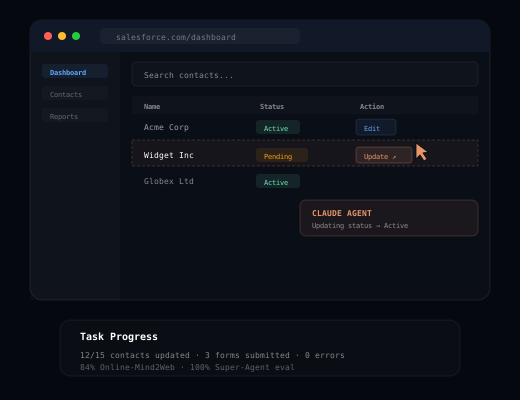
84% op Online-Mind2Web — de hoogste score onder frontiermodellen voor op browsers gebaseerde taakautomatisering. 100% voltooiingspercentage op Anthropic's interne Super-Agent evaluatie. Claude Opus 4.8 kan het web navigeren, formulieren invullen, interageren met gebruikersinterfaces en meerstapscomputertaken uitvoeren zonder menselijke tussenkomst.
Wiskundig en Wetenschappelijk Redeneren
Van 69,3% naar 96,7% op USAMO 2026 — een sprong van 27 punten die Claude Opus 4.8 in een klasse apart plaatst op het gebied van wiskundig redeneren. Nr. 1 op Humanity's Last Exam en koploper in CritPt-grensnatuurkunde. Wetenschappelijk onderzoek, kwantitatieve analyse en probleemoplossing op theoremenniveau vallen nu binnen het bereik van één enkele API-aanroep.
Eerlijkheid en Hallucinatieweerstand
35,9% hallucinatiepercentage op AA-Omniscience — het laagste onder alle frontiermodellen, aanzienlijk lager dan concurrenten van Google en OpenAI. Claude Opus 4.8 onthoudt zich bij onzekerheid in plaats van overtuigende maar onjuiste antwoorden te fabriceren. Evaluaties van sycofantie onder druk: 0%. Als je een model nodig hebt dat je echt kunt vertrouwen voor beslissingen met hoge inzetten, is dit de standaard.
Wat Claude Opus 4.8 Onderscheidt
Nr. 1 Intelligence Index
61,4 op de onafhankelijke Intelligence Index van Artificial Analysis — de meest rigoureuze derde-partij ranking van frontiermodellen. Claude Opus 4.8 verslaat GPT-5.5 Pro (60,2) en Gemini 3.1 Pro (57,0) in directe evaluaties, en wint 67% van de directe vergelijkingen tegen GPT-5.5. Geen enkele door Anthropic uitgekozen benchmark — een onafhankelijke samengestelde score over tientallen taken.
Laagste Hallucinatiepercentage
35,9% hallucinatiepercentage op AA-Omniscience, aanzienlijk lager dan alle andere frontiermodellen. Als Claude Opus 4.8 iets niet weet, zegt het dat ook. Nulscore op evaluaties van sycofantie onder druk: het model verandert een correct antwoord niet omdat een gebruiker aandringt. Voor juridisch, medisch, financieel en technisch werk telt dit meer dan welke benchmarkscore dan ook.
Contextvenster van 1M Tokens
Één miljoen tokens op Claude API, Amazon Bedrock en Google Vertex AI (200K op Microsoft Foundry). Dat zijn complete codebases, onderzoeksbibliotheken van meerdere delen en een jaar aan gespreksgeschiedenissen in één enkele context. Maximale output: 128K tokens per aanroep. De kwaliteit van ophalen met lange context blijft competitief aan de top van MRCR-evaluaties.
Fast Mode: 2,5× Sneller, 3× Goedkoper
Fast Mode kost $10 invoer / $50 uitvoer per miljoen tokens — tegenover de standaard $15/$75. De doorvoer neemt toe met 2,5×. Voor latentiegevoelige agentische werklasten, verwerking van grote documentvolumes en kostenefficiënte productiepijplijnen maakt Fast Mode Opus 4.8 prijscompetitief zonder over te stappen op een kleiner model.
Claude Opus 4.8 vs Frontiermodellen
Onafhankelijke benchmarkgegevens op het gebied van codering, redeneren, wetenschap en prijsstelling.
| Features |  Claude Opus 4.8 Anthropic |  GPT-5.5 Pro OpenAI |  Gemini 3.1 Pro Google |  DeepSeek V4 Pro DeepSeek |
|---|---|---|---|---|
| Intelligence Index | 61.4 (#1) | 60.2 | 57.0 | TBD |
| SWE-bench Verified | 88.6% | ~80% | ~78% | 80.6% |
| USAMO 2026 Wiskunde | 96.7% | TBD | TBD | TBD |
| Hallucinatiepercentage | 35.9% (lowest) | ~45% | ~50% | TBD |
| Computergebruik / Browser | 84% | 78.7% | TBD | TBD |
| Contextvenster | 1M tokens | 1M tokens | 1M+ tokens | 1M tokens |
| Invoerprijs / M tokens | $5.00 | $5.00 | $2.00 | $0.435 |
| Uitvoerprijs / M tokens | $25.00 | $30.00 | $12.00 | $0.87 |
| Fast / Turbo Mode | 2.5× speed @ $10/$50 | N/A | Thinking levels | N/A |
| Promptcaching | ||||
| Systeemberichten Halverwege het Gesprek |
Dynamic Workflows — Agentische AI op Schaal
Van één prompt naar gecoördineerde multi-agentuitvoering
Benchmarkprestaties
Claude Opus 4.8 in onafhankelijke evaluaties — codering, wiskunde, wetenschap en betrouwbaarheid.
Waarvoor Claude Opus 4.8 Is Gebouwd
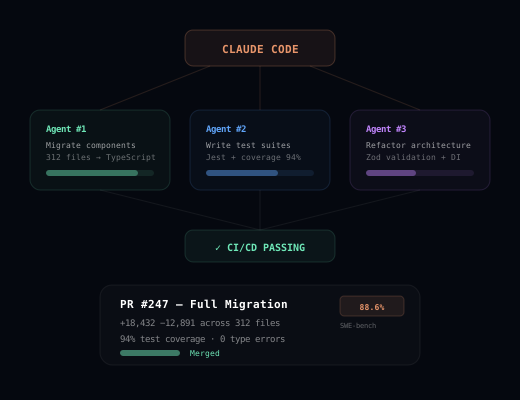
Agentic Coding & Refactoring
Spawn parallelle subagenten om codebases te migreren, testsuites te schrijven, architectuur te refactoren en bugs op te lossen over honderdduizenden regels code. Claude Code draait Opus 4.8 native.
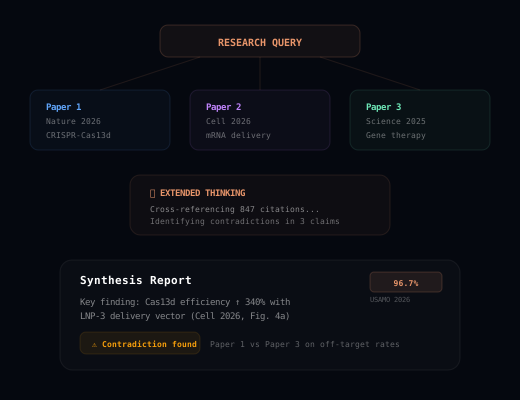
Scientific Research & Analysis
GPQA Diamond, HLE, CritPt — Claude Opus 4.8 leidt op elke frontier-wetenschapsbenchmark. Ideaal voor literatuursynthese, hypothesegeneratie en kwantitatieve analyse.
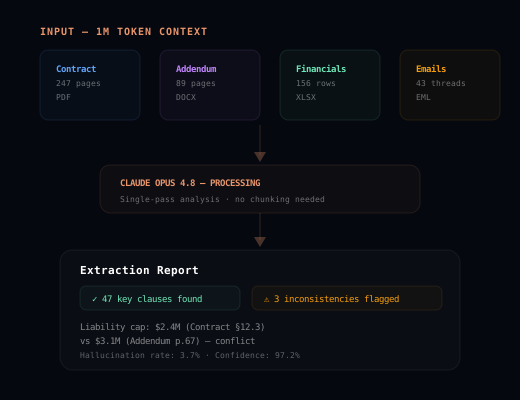
Enterprise Document Processing
Contextvenster van 1M tokens verwerkt complete contractbibliotheken, audittrails en beleidskorpora. Extraheer, vergelijk, classificeer en vat samen op schaal met het laagste hallucinatiepercentage in het veld.
Browser Automation & Computer Use
84% op Online-Mind2Web. Claude Opus 4.8 navigeert echte websites, vult formulieren in, werkt samen met bureaubladinterfaces en voltooit meerstapstaken zonder menselijke begeleiding.
Eerlijke Beperkingen
Wanneer Claude Opus 4.8 niet de beste keuze is — en wat je dan beter kunt gebruiken
Wat Experts Zeggen over Claude Opus 4.8
Topped the Intelligence Index
61.4 — the highest independent composite score of any frontier model.
Claude Opus 4.8 is the new leader on the Artificial Analysis Intelligence Index. Opus 4.8 scores 61.4, up +4.1 points from Opus 4.7 and +1.2 points ahead of GPT-5.5, the previous Index leader.
Dramatically More Honest
4× less likely to let code flaws pass unmentioned versus its predecessor.
Opus 4.8 is around four times less likely than its predecessor to allow flaws in code it has written to pass unremarked. It achieved the lowest incorrect-rate of six models on every benchmark — the most direct measure of factual hallucination.
SWE-bench Leader
Highest real-world coding score among frontier text models.
Opus 4.8 improves across benchmarks, especially the agentic-work stack. SWE-Bench Verified: 88.6%. The headline upgrade is judgment, not raw intelligence: Anthropic says it is around four times less likely than Opus 4.7 to let flaws in its own code pass unremarked.