4× Faster. Same Intelligence.
Gemini 3.5 Flash — the fastest frontier model. $0.15/M input, $0.60/M output. Thinking on demand. On Yesmind.
Wat is Gemini 3.5 Flash?
Gemini 3.5 Flash is het <span class="hl-pill">snelste frontier-AI-model</span> van Google, uitgebracht op 19 mei 2026 op Google I/O. Op ongeveer <span class="hl-pill">280 uitvoertokens per seconde</span> draait het circa 4× sneller dan GPT-5.5 en Claude Opus 4.8 — terwijl het hen evenaart of overtreft op agentisch coderen, langcontext-retrieval en multimodale benchmarks. Het is vandaag algemeen beschikbaar als <code>gemini-3.5-flash</code> zonder preview-achtervoegsel en zonder wachtlijst.
De kernstelling van het model is dat snelheid en intelligentie niet langer een afweging zijn. <span class="hl-pill">SWE-Bench 81.0%</span> en <span class="hl-pill">Terminal-Bench 76.2%</span> overtreffen beide Google's eigen vorige Pro-tiermodel. Op de MRCR v2 langcontext-retrievalbenchmark scoort Gemini 3.5 Flash 77.3% bij 128k tokens — vergeleken met 46.9% van Claude Opus 4.8 en 41.4% van GPT-5.5. Dit is geen afgeslankt model voor goedkope taken; het is een volwaardig <span class="hl-pill">frontier-klasse intelligentie</span>-engine gebouwd voor productieniveau agentische workloads.
<span class="hl-pill">Echte native multimodaliteit</span> onderscheidt Gemini 3.5 Flash van elke concurrent: tekst, afbeelding, audio, video en PDF worden allemaal verwerkt in één API-aanroep, zonder aparte modelrouting of preprocessingpipeline. Gecombineerd met <span class="hl-pill">Thinking Levels</span> (Minimal tot High) voor granulaire kosten-kwaliteitscontrole, en diepe integratie in Google's Antigravity 2.0 agentische infrastructuur, is Gemini 3.5 Flash het model om naar te grijpen wanneer je frontier-resultaten nodig hebt op een productiebudget.
4× Snelheidsvoordeel
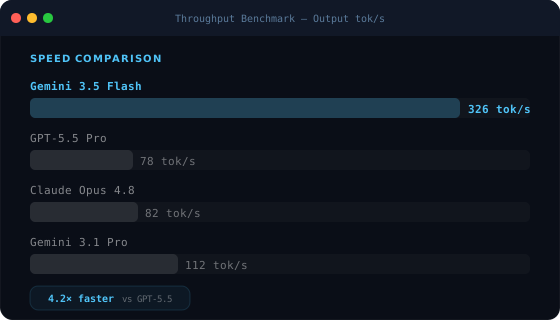
~326 tok/s uitvoer — 4× sneller dan GPT-5.5 Pro (78 tok/s) en Claude Opus 4.8 (82 tok/s). Voor agentische pipelines die dagelijks miljoenen tokens verwerken, vertaalt dit verschil zich rechtstreeks in besparingen op kosten en latentie.
Echte Native Multimodaliteit
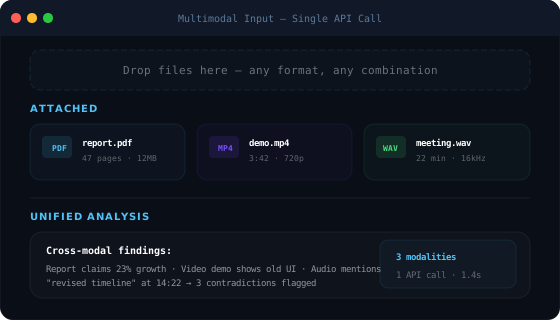
Tekst, afbeeldingen, audio, video, PDF's — één modelaanroep, geen routing, geen preprocessing. 84% MMMU-Pro — de hoogst geregistreerde multimodale score. Vijf modaliteiten native, niet als add-ons.
1M Tokencontext met Beste Retrieval
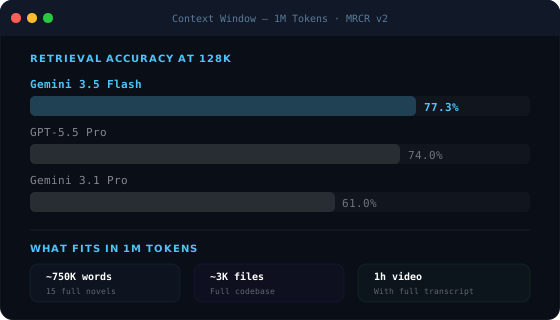
1M tokens met 77.3% MRCR v2-retrieval bij 128K — tegenover Claude Opus 46.9% en GPT-5.5 41.4%. Het accepteert niet alleen lange contexten — het haalt er nauwkeurig informatie uit op.
Denkniveaus
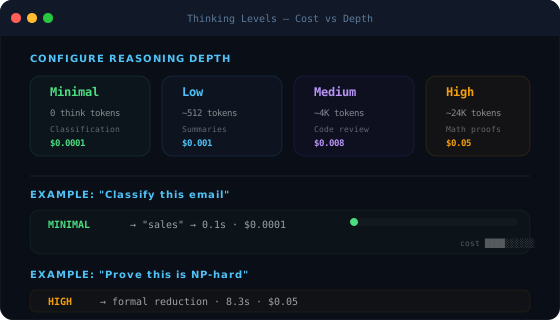
Vier modi — Minimal, Low, Medium, High — stemmen kosten en diepte af per verzoek. Minimal: $0.0001 voor classificatie. High: volledig redeneren voor wiskundige bewijzen. Één endpoint, vier profielen, nul infracomplexiteit.
Integratie met het Google-ecosysteem
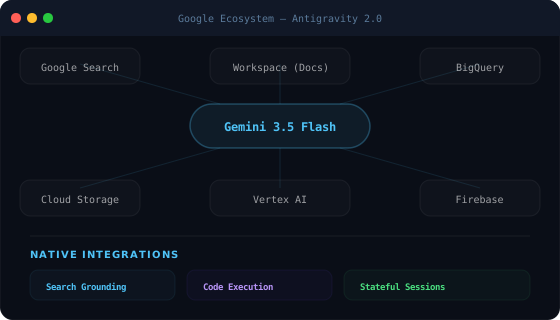
Antigravity 2.0: stateful sandboxes, multi-agent parallelisme, MCP-tools — ingebouwd. Native Search grounding vervangt RAG. Directe integratie met Workspace, BigQuery, Vertex AI, Firebase.
Gemini 3.5 Flash versus topcompetitors
Onafhankelijke benchmarkgegevens — bekijk waar elk model uitblinkt en waar het concessies doet.
| Features |  Gemini 3.5 Flash Google |  GPT-5.5 OpenAI |  Claude Opus 4.8 Anthropic |  DeepSeek V4 Pro DeepSeek |
|---|---|---|---|---|
| Uitvoersnelheid (tok/s) | ~280 | ~70 | ~60 | ~80 |
| SWE-Bench | 81.0% | ~80% | 80.6% | 80.6% |
| Terminal-Bench 2.1 | 76.2% | 82.7% | 69.4% | 67.9% |
| MRCR v2 128k | 77.3% | 41.4% | 46.9% | TBD |
| MMMU-Pro (Multimodaal) | 84% | TBD | TBD | TBD |
| Contextvenster | 1M tokens | 1M tokens | 200K+ | 1M tokens |
| Invoerprijs per 1M | $1.50 | $5.00 | $15.00 | $0.435 |
| Uitvoerprijs per 1M | $9.00 | $30.00 | $25.00 | $0.87 |
| Native modaliteiten | Text+Image+Audio+Video+PDF | Text+Image+Audio+Video | Text+Image | Text only |
| Denk- / Redeneermodi | 4 levels (Minimal–High) | |||
| Agentische infrastructuur | Antigravity 2.0 (native) | OpenAI Responses API | Claude Code | Limited |
| Korting op contextcaching | 90% ($0.15/M) | 50% | 90% | 75% |
Benchmarkprestaties
Gemini 3.5 Flash op onafhankelijke evaluaties van derden — agentisch, coderen, multimodaal en retrieval
Wie Gemini 3.5 Flash gebruikt — en hoe
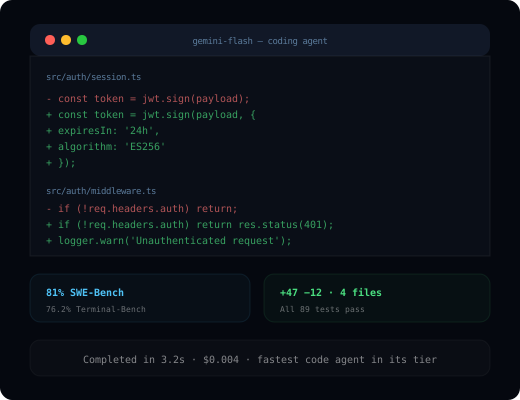
Agentic Coding
81% SWE-Bench, 76.2% Terminal-Bench. Antigravity 2.0 stateful sandboxes + multi-agent parallelisme voor multi-repo workflows. MCP-toolprotocollen voor tests, commits, implementaties — autonoom.
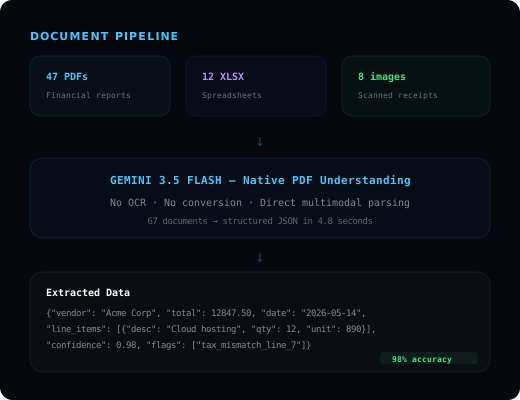
Document Processing
Native PDF-begrip — geen OCR, geen conversie. Upload financiële overzichten, contracten of onderzoekspapers en ontvang gestructureerde JSON in één aanroep. 1M context + 77.3% retrievalnauwkeurigheid.
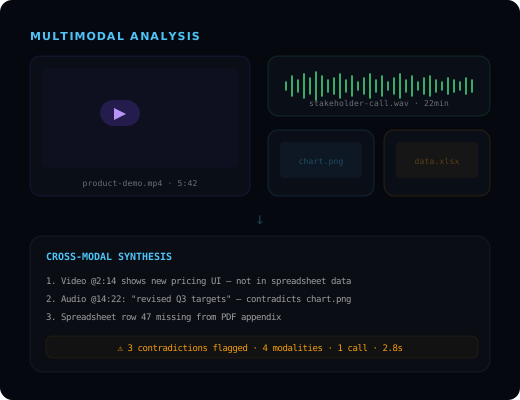
Multimodal Analysis
Video + audio + afbeeldingen + tekst in één API-aanroep. Analyseer productdemo's, transcribeer vergaderingen, combineer grafieken met spreadsheets. 84% MMMU-Pro — de hoogst geregistreerde multimodale score.
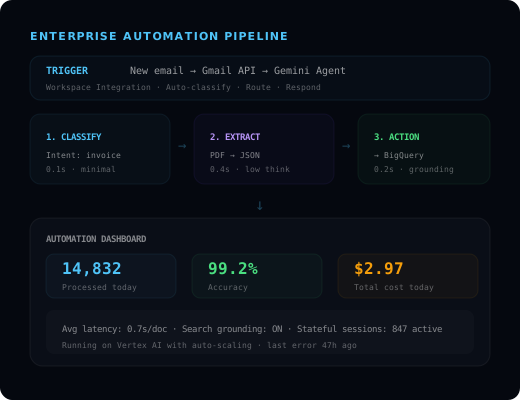
Enterprise Automation
Google Workspace, Search grounding, BigQuery, Vertex AI — alles native. 90% korting op contextcaching. Thinking Levels stemmen rekenkracht af op taakcomplexiteit. Drijft de AI-modus aan voor meer dan 1 miljard gebruikers.
Hoe Het Werkt
Elke invoermodaliteit, directe resultaten, infrastructuur op Google-schaal
Stuur Elke Modaliteit
Geef tekst, afbeeldingen, audio, video of PDF-documenten door — individueel of gecombineerd — in één API-verzoek. Geen preprocessing, geen aparte modelrouting, geen conversiepipeline. Het model accepteert ruwe bestanden naast je prompt en verwerkt alles native.
Flash-verwerking
Gemini 3.5 Flash voert uit op ~280 uitvoertokens per seconde via de productie-TPU-infrastructuur van Google. Selecteer je Thinking Level (Minimal tot High) om het redeneerbudget voor je taak af te stemmen. Contextcaching verlaagt de kosten met 90% voor herhaalde document- of systeempromptonderdelen.
Directe Gestructureerde Respons
Ontvang tekst, gestructureerde JSON, code of uitvoer van functieaanroepen in realtime via streaming. Voor agentische pipelines op Antigravity 2.0 kan het model tools aanroepen, subagenten spawnen en de toestand bewaren over meerstapstaken — allemaal binnen dezelfde sessie.
Wat Gemini 3.5 Flash Onderscheidt
4× Sneller dan Frontier-rivalen
~280 uitvoertokens per seconde plaatst Gemini 3.5 Flash in een categorie op zich op het frontier-intelligentieniveau. GPT-5.5 levert ~70 tok/s; Claude Opus 4.8 ~60 tok/s. Voor agentische systemen die dagelijks miljoenen tokens verwerken, is het doorvoerverschil het onderscheid tussen economisch haalbaar of niet. Dit is het model dat real-time AI op frontier-kwaliteit mogelijk maakt.
Native Vijf-modaliteiteninvoer
Tekst, afbeelding, audio, video en PDF — allemaal native verwerkt in één modelaanroep. Geen externe OCR-pipeline voor PDF's. Geen aparte audiotranscriptiestap. Geen afbeelding-naar-tekst-preprocessing. Concurrenten verwerken één of twee modaliteiten native; Gemini 3.5 Flash verwerkt alle vijf. MMMU-Pro 84% is de hoogst geregistreerde multimodale benchmarkscore.
77.3% MRCR Langcontext-retrieval
Een contextvenster van 1M tokens hebben is één ding. Daadwerkelijk de juiste informatie eruit ophalen is iets anders. MRCR v2 bij 128k: Gemini 3.5 Flash 77.3% versus Claude Opus 4.8 46.9% versus GPT-5.5 41.4%. Een nauwkeurigheidsvoordeel van 30 punten dat telt voor juridische, financiële en onderzoeksdocumentworkflows waarbij het missen van één clausule echte gevolgen heeft.
90% Korting op Contextcaching
Herhaalde context — systeemprompts, referentiedocumenten, gespreksgeschiedenis — kost $0.15/M gecachede tokens in plaats van het standaard $1.50/M. Voor agentische workflows die dezelfde codebase, beleidsdocument of kennisbank raadplegen bij duizenden verzoeken, verlaagt caching alleen al de totale inferentiekosten met 30–50%. De economie van langcontext-AI verandert fundamenteel bij dit kortingspercentage.