Ask. It Builds.
Natural language in, autonomous execution out. GPT-5.5 Pro on Yesmind handles the rest.
Wat is GPT-5.5 Pro?
GPT-5.5 Pro is OpenAI's tot nu toe meest capabele taalmodel — een <span class="hl-pill">volledig heropgebouwde</span> GPT-architectuur, geen incrementele patch. Intern de codenaam "Spud" gekregen, vertegenwoordigt het het eerste volledig opnieuw getrainde basismodel sinds GPT-4.5. Het resultaat is een <span class="hl-pill">frontier AI-model</span> dat niet alleen reageert op instructies — het plant, redeneert en voert meerstappige taken uit zoals een ervaren engineer een complex project zou aanpakken.
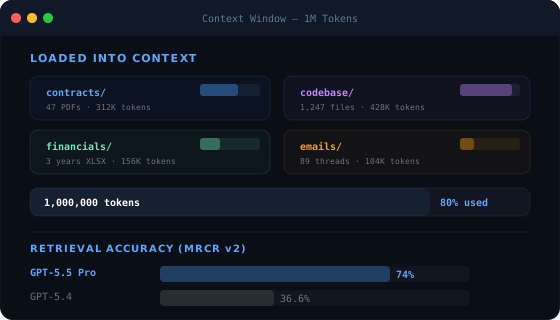
Waar eerdere modellen zorgvuldige prompt engineering vereisten om op koers te blijven, introduceert GPT-5.5 Pro <span class="hl-pill">langetermijnprobleemoplossing</span> als een native mogelijkheid. Het contextvenster van 1 miljoen tokens is niet slechts een opvallend getal — MRCR v2 opvraging bij 512K–1M tokens bereikt 74%, vergeleken met 36,6% voor GPT-5.4. Volledige codebases, juridische documentensets en onderzoekscorpora passen in één enkel gesprek zonder coherentie te verliezen.
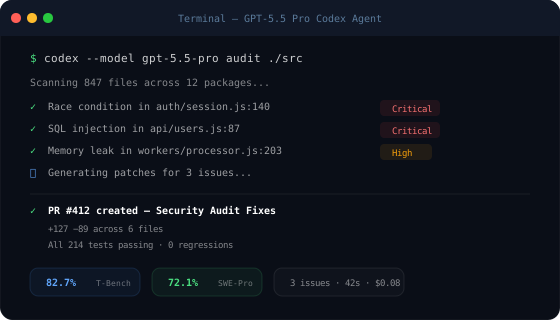
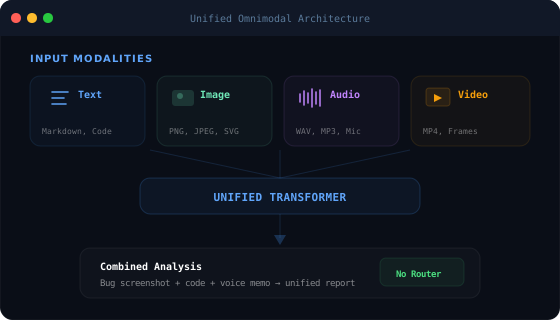
Het model is ook <span class="hl-pill">native omnimodaal</span>: tekst, afbeeldingen, audio en video delen een uniforme architectuur zonder overhead door modaliteitsomschakeling. Combineer dat met 82,7% op <span class="hl-pill">Terminal-Bench 2.0</span> — 13 punten voor op Claude Opus 4.7 — en je hebt het eerste model dat de titel van autonome AI-agent voor echte productiewerklasten werkelijk verdient.
Agentisch programmeren
82,7% op Terminal-Bench 2.0 — 13 punten voor op Claude Opus 4.7. Autonome shellnavigatie, toolorkestratie en manipulatie van codebases met meerdere bestanden. Geen assistent — een autonome engineer.
1M token context
1M tokens met 74% MRCR v2 ophaalnauwkeurigheid — 2× GPT-5.4, 2,3× Claude Opus 4.7. Geef het een volledig repo, een jaar aan dossiers of een heel zaakdossier. Het leest, onthoudt en redeneert over het geheel.
Native omnimodaal
Tekst, afbeeldingen, audio, video — één uniforme architectuur. Geen modaliteitsrouter, geen conversieverliezen. Screenshot + code, video + transcript, PDF + grafiek + voice-memo in één enkel verzoek.
Computergebruik
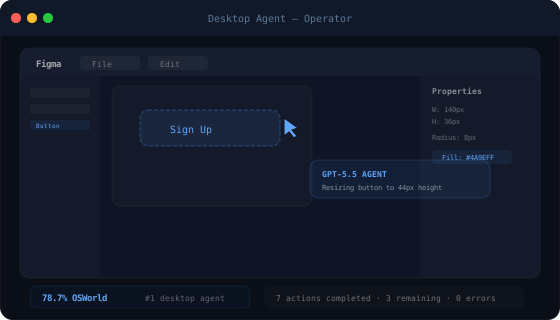
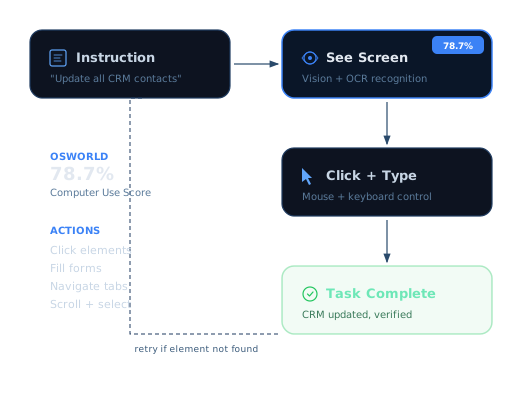
78,7% op OSWorld — echte desktopautomatisering. Navigeer door GUI's, vul formulieren in, bedien applicaties en voer meerstappige workflows uit. Computergebruik gaat van demo naar inzetbaar product.
Webonderzoek
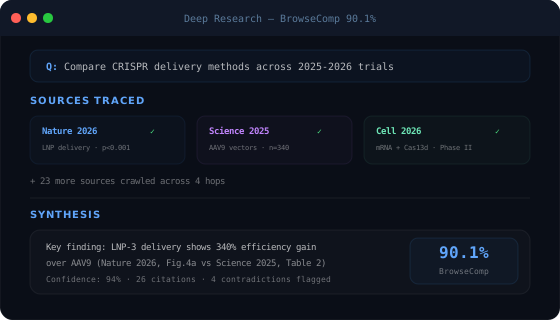
90,1% op BrowseComp — multi-hop queries over tientallen bronnen. Overtroeft Gemini 3.1 Pro (85,9%) en Claude Opus 4.7 (79,3%). Autonome bewijsketens, geciteerde conclusies.
Wat GPT-5.5 Pro anders maakt
Volledig opnieuw opgebouwd
GPT-5.5 Pro is niet GPT-5.4 met extra lagen. Het is het eerste volledig opnieuw getrainde basismodel sinds GPT-4.5 — een complete architectuurherziening met de codenaam "Spud". Elke capabiliteitverbetering bouwt voort op een sterkere basis, niet op patches van bestaande beperkingen. Daarom zijn de benchmarksprongen discontinu: je vergelijkt geen versies, je vergelijkt generaties.
Snelheidspariteit per token
Capabeler hoeft niet trager te betekenen. GPT-5.5 Pro is samen ontworpen met NVIDIA GB200 en GB300 hardware om een tokengeneratiesnelheid van meer dan 20% boven GPT-5.4 te bereiken, terwijl het een grotere capaciteit levert. Productiepijplijnen krijgen tegelijkertijd een sneller en slimmer model — een combinatie die nooit eerder mogelijk was bij de ontwikkeling van frontiermodellen.
72% minder outputtokens
Ondanks een hogere lijstprijs per token ($30/M output), genereert GPT-5.5 Pro ongeveer 72% minder outputtokens dan Claude Opus 4.8 om equivalente codeertaken te voltooien. Het model communiceert precies en handelt efficiënt, wat betekent dat de werkelijke kosten voor agentische codeerpijplijnen op ongeveer de helft van het Claude-equivalent uitkomen. Betere benchmarks bij lagere werkelijke uitgaven.
NVIDIA hardware co-ontwerp
GPT-5.5 Pro werd niet geïsoleerd getraind en op standaardhardware uitgerold. OpenAI en NVIDIA ontwierpen de modelarchitectuur samen met het GB200/GB300 NVL72 rack, waardoor kernel-level optimalisaties mogelijk zijn die onzichtbaar zijn voor afzonderlijk getrainde modellen. Het resultaat is een inferentie-efficiëntie die het kostenvoordeel van kortere outputreeksen verder versterkt.
GPT-5.5 Pro vs de concurrentie
Onafhankelijke benchmarkresultaten — alle modellen beschikbaar op Yesmind.
| Features |  GPT-5.5 Pro OpenAI |  Claude Opus 4.8 Anthropic |  Gemini 3.5 Flash Google |  DeepSeek V4 Pro DeepSeek |
|---|---|---|---|---|
| Terminal-Bench 2.0 | 82.7% | ~70% | 68.5% | TBD |
| ARC-AGI-2 | 85.0% | 75.8% | 77.1% | TBD |
| FrontierMath T1–3 | 51.7% | 43.8% | 36.9% | TBD |
| BrowseComp | 90.1% | 79.3% | 85.9% | TBD |
| OSWorld (Computergebruik) | 78.7% | 78.0% | TBD | TBD |
| Contextvenster | 1M tokens | 200K+ tokens | 1M+ tokens | 1M tokens |
| MRCR v2 (512K–1M) | 74% | 32.2% | TBD | TBD |
| Outputprijs | $30/M tokens | $25/M tokens | $3.50/M tokens | $0.44/M tokens |
| Agentisch programmeren | ||||
| Computergebruik | ||||
| Native omnimodaal |
Benchmarkprestaties
GPT-5.5 Pro in de belangrijkste evaluaties die relevant zijn voor echte werklasten
Wat mensen bouwen met GPT-5.5 Pro
Coding Agents
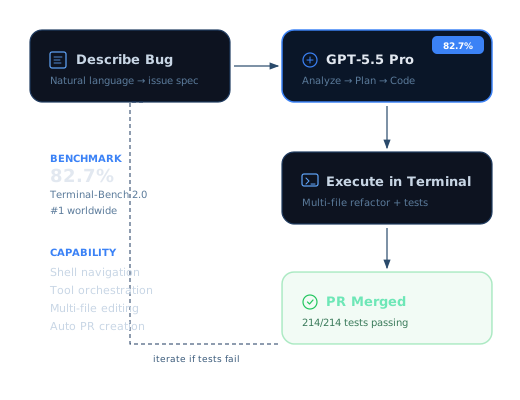
Autonome software-engineering op schaal. GPT-5.5 Pro navigeert door codebases, schrijft en test code, lost problemen op in meerdere bestanden en dient werkende pull requests in zonder begeleiding. De 82,7% Terminal-Bench score weerspiegelt hoe dit eruitziet in productie.
Research Workflows
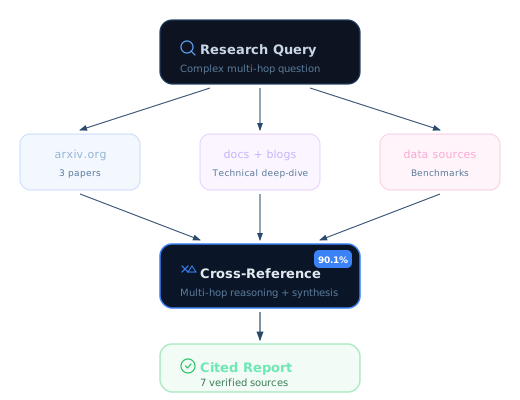
Diepgaand onderzoek uit meerdere bronnen dat vroeger een team van analisten vereiste. De 90,1% BrowseComp score van GPT-5.5 Pro betekent dat het obscure feiten kan opsporen, tegenstrijdige bronnen kan samenvatten en een geciteerd overzicht kan teruggeven — het soort onderzoeksresultaat dat vroeger uren kostte.
Document Processing
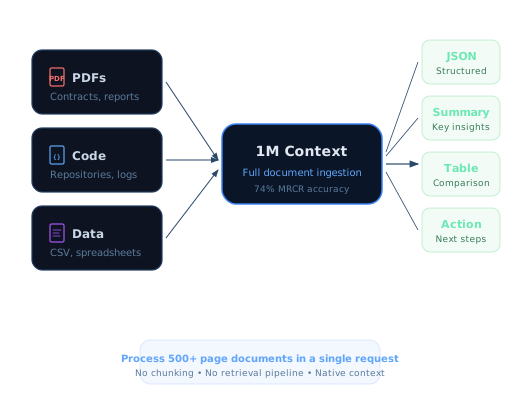
Geef GPT-5.5 Pro een complete set juridische contracten, een financieel auditpakket of een bibliotheek met technische specificaties. Met 1M tokens context en 74% MRCR v2 ophaalnauwkeurigheid glipt er niets doorheen. Extraheer, vergelijk, vat samen en markeer — over documenten die vroeger gespecialiseerde teams vereisten.
Desktop Automation
De 78,7% OSWorld score van GPT-5.5 Pro vertaalt zich naar echte desktoptaakuitvoering: navigeren door complexe UI's, formulieren invullen in verschillende applicaties, multi-app workflows coördineren en taken voltooien die vroeger een mens aan het toetsenbord vereisten. Computergebruik dat daadwerkelijk werkt in productie.
Hoe GPT-5.5 Pro werkt
Van één enkele prompt naar autonome meerstappige uitvoering
Jij bepaalt het doel
Beschrijf wat je wilt bereiken — niet hoe je het moet doen. GPT-5.5 Pro accepteert natuurlijke taal, code, afbeeldingen, documenten en audio als invoer. Jij stelt het doel; het model bepaalt de aanpak. Hoe meer context je aanlevert, hoe nauwkeuriger het kan plannen.
Het model plant & redeneert
GPT-5.5 Pro splitst het doel op in een reeks stappen, identificeert welke tools en informatie nodig zijn en stelt een uitvoeringsplan op voordat het handelt. Deze interne redenerstap — aanzienlijk opgeschaald in de Thinking-variant — is wat autonome uitvoering onderscheidt van reactieve responsgeneratie.
Autonome uitvoering
Het model voert het plan uit: tools aanroepen, op het web surfen, code schrijven en uitvoeren, applicaties bedienen of meerstappige workflows coördineren. Elk tussenresultaat wordt geëvalueerd voordat de volgende stap wordt gezet. Je ontvangt een volledig, geverifieerd resultaat — geen half afgewerkt concept.
Wat bouwers zeggen over GPT-5.5 Pro
A Top-End Senior Engineer
GPT-5.5 scored 62.5 on Every's Senior Engineer Benchmark — nearly double Opus 4.7's 33.5. It rewrites messy production codebases the way a senior engineer would, with cleaner structure and smoother logical progression.
It’s rare for a model to feel easier and stronger at the same time. GPT-5.5 is fast enough to use constantly, personable enough to collaborate with, and assertive enough to carry a plan through serious engineering work.
Code Review That Catches What Humans Miss
Ramp's AI DevEx team integrated Codex with GPT-5.5 into their code review flow. Engineers now request it by name for its thoroughness and ability to reason deeply against the codebase.
Codex code review catches things that I miss and that other engineers miss and that other AI code reviewers definitely miss.
Smarter and More Efficient Than Opus
Developers on r/ClaudeCode compared GPT-5.5 directly against Opus 4.7 for software design. The consensus: GPT-5.5 produces higher quality code with fewer tokens and offers substantially higher usage limits.
It is smarter than Opus and more efficient. GPT reviewed my codebase which was done by Opus 4.6 and 4.7 and it found so many bugs. The code quality is great and the speed is so much faster.
Token-efficiëntie: het verborgen kostenvoordeel
Met $30 per miljoen outputtokens ligt de lijstprijs van GPT-5.5 Pro boven die van Claude Opus 4.8 op $25/M. Op papier is dat 20% duurder. In de praktijk geldt het omgekeerde voor de werklasten die er het meest toe doen.
<strong>GPT-5.5 Pro genereert ongeveer 72% minder outputtokens dan Claude Opus 4.8</strong> om dezelfde codeertaken te voltooien. Het schrijft beknoptere code, elimineert uitgebreide commentaren en trekt conclusies zonder inleiding. Dat efficiëntievoordeel keert de prijsvergelijking per token om: de effectieve kosten per voltooide taak liggen op ongeveer de helft van het Claude-equivalent voor engineeringpijplijnen.
De efficiëntiewinst wordt versterkt door de meer dan 20% snelheidsverbetering in tokengeneratie ten opzichte van GPT-5.4. Snellere inferentie betekent kortere kloktijd per verzoek, wat de kosten van tijdgevoelige agentische workflows direct verlaagt wanneer latentie de doorvoer beïnvloedt. Teams die duizenden dagelijkse API-aanroepen uitvoeren, merken dat de werkelijke rekening totaal anders uitpakt dan de theoretische berekeningen.
<strong>De praktische implicatie:</strong> stuur je meest omvangrijke agentische coderingswerk via GPT-5.5 Pro. De benchmarkvoorsprong betaalt zichzelf terug vóór de eerste factuur.