685B Brain. 52B Active.
DeepSeek V4 Pro — Mixture-of-Experts routes each request to specialized sub-networks. Frontier knowledge at mid-size cost. On Yesmind.
Gen
Logic
Med
Doc
Core
Parse
Mol
Chain
late
Struct
Wat is DeepSeek V4 Pro?
DeepSeek V4 Pro is een <span class="hl-pill">groot taalmodel van frontierklasse</span> dat de aanname doorbreekt dat geavanceerde AI duur en gesloten moet zijn. Uitgebracht in 2026 onder een <span class="hl-pill">MIT-licentie</span>, behaalt het 80,6% op SWE-bench Verified — gelijkwaardig aan Claude Opus 4.8 en dichtbij GPT-5.5 — voor slechts $0,435 per miljoen invoertokens. Dat is ongeveer 30 keer goedkoper dan Claude en 11 keer goedkoper dan GPT-5.5 bij equivalente uitvoerkwaliteit.
Het model is gebouwd op een <span class="hl-pill">Mixture of Experts (MoE)-architectuur</span> met 1,6 biljoen totale parameters maar slechts 49 miljard actief per token. Dit ontwerp geeft DeepSeek V4 Pro de kennisbreedte van een massief model terwijl de inferentiekosten dicht bij die van een middelgroot dense model blijven. Het resultaat: frontierintelligentie zonder frontierprijzen.
DeepSeek V4 Pro ondersteunt een <span class="hl-pill">contextvenster van 1 miljoen tokens</span>, drie adaptieve redeneermodi, een volledig OpenAI-compatibele API en agentische functieaanroepworkflows. Het werd getraind op Huawei Ascend AI-hardware — het eerste frontiermodel volledig buiten het Nvidia-ecosysteem gebouwd — wat aantoont dat onafhankelijkheid van de toeleveringsketen en onderzoeksexcellentie naast elkaar kunnen bestaan.
Op Yesmind heb je rechtstreeks toegang tot DeepSeek V4 Pro via onze uniforme interface — geen aparte API-sleutels, geen SDK-migratie, geen extra installatie. Één abonnement, elk frontiermodel.
Extreme Kostenefficiëntie
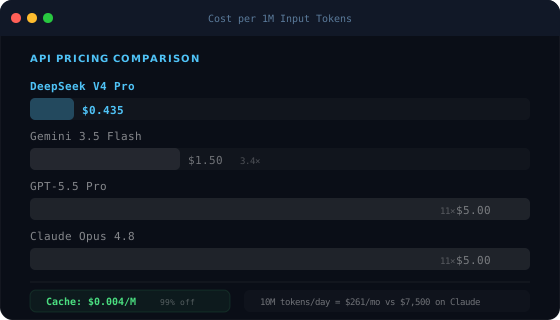
$0,435/M invoer — 11× goedkoper dan GPT-5.5, 29× goedkoper dan Claude Opus. Cache-hits voor $0,004/M. Een werkbelasting van 10 miljoen tokens per dag: $261/maand versus $7.500 bij Claude.
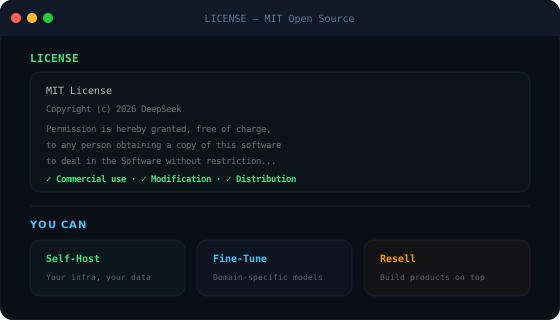
MIT-licentie — Echte Open Source
Zelf hosten, fine-tunen, doorverkopen — geen beperkingen. In tegenstelling tot de Llama-licentie: geen gebruikerslimieten, geen naamgevingsvereisten, geen uitzonderingen. Gewichten beschikbaar op HuggingFace.
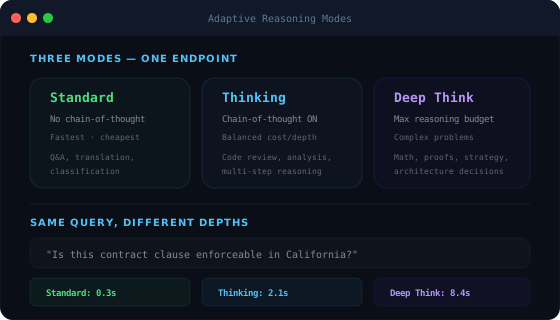
Drie Adaptieve Redeneermodi
Standaard: snel, geen chain-of-thought. Thinking: uitgebalanceerde redenering voor code en analyse. Deep Think: maximale diepte voor bewijzen en architectuur. Één endpoint, drie profielen.
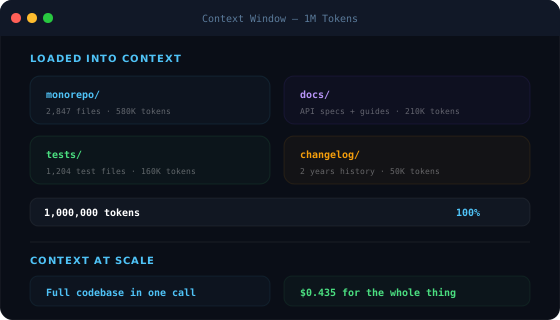
Contextvenster van 1 Miljoen Tokens
Volledige codebases, juridische contracten, onderzoeksbibliotheken — in één keer. Hybride aandacht reduceert de FLOPs tot 27% van V3.2 bij 1M context. Langdurige context die economisch haalbaar is.
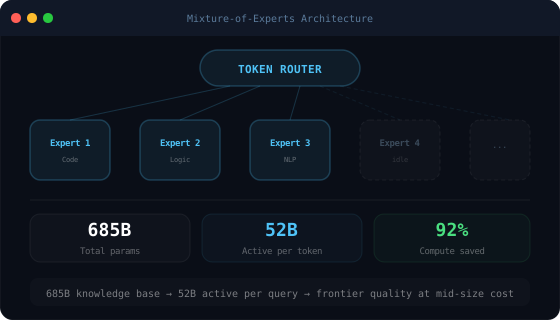
MoE-architectuur — Massieve Kennis, Gematigde Kosten
685 miljard totale parameters, 52 miljard actief per token. De router selecteert gespecialiseerde expertgroepen per query — frontierkennis tegen de rekenkosten van een middelgroot model. 92% besparing ten opzichte van het equivalente dense model.
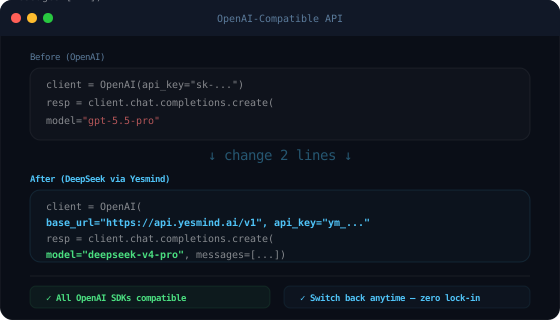
OpenAI-Compatibele API — Geen Migratie Nodig
Verander base_url en de modelnaam — dat is alles. Alle OpenAI SDK's werken. Ondersteunt ook het Anthropic-formaat. Geen vendor lock-in, schakel op elk moment terug.
DeepSeek V4 Pro vs. Topmodellen voor AI
Hoe DeepSeek V4 Pro zich verhoudt tot GPT-5.5, Claude Opus 4.8 en Llama 4 Maverick op het gebied van benchmarks, prijzen en open-source toegang.
| Features |  DeepSeek V4 Pro DeepSeek AI |  GPT-5.5 OpenAI |  Claude Opus 4.8 Anthropic | Llama 4 Maverick Meta |
|---|---|---|---|---|
| SWE-bench Verified | 80.6% | ~80% | 80.6% | ~65% |
| LiveCodeBench | 93.5% | ~90% | ~88% | TBD |
| Codeforces-rating | 3,206 | TBD | TBD | TBD |
| Contextvenster | 1M tokens | 1M tokens | 200K+ | 1M tokens |
| Invoerprijs | $0.435/M | $5/M | $15/M | Free (open) |
| Uitvoerprijs | $0.87/M | $30/M | $25/M | Free (open) |
| Open Source | ||||
| Zelf te Hosten | ||||
| Redeneermodi | 3 (Non-Think / High / Max) | Standard + Thinking | Standard + Extended | Standard |
| Trainingshardware | Huawei Ascend | Nvidia | Nvidia | Nvidia |
Hoe DeepSeek V4 Pro Werkt
MoE-routering — frontierkennis tegen de inferentiekosten van een middelgroot model
Jouw Prompt Gaat het Model In
Elk verzoek wordt getokeniseerd en doorgegeven aan de routeringslaag van DeepSeek V4 Pro. Het MoE-gatenetwerk evalueert onmiddellijk welke expert-subnetwerken het meest relevant zijn voor jouw specifieke invoer — code, wiskunde, taal of redenering — voordat er een enkele rekenintensieve bewerking begint.
49 Miljard Actieve Parameters Verwerken de Inferentie
Van de 1,6 biljoen totale parameters worden er slechts ~49 miljard geactiveerd per token. De geselecteerde experts verwerken jouw verzoek met de diepte van een massief model, maar tegen de rekenkosten van een middelgroot dense model. Daarom levert DeepSeek V4 Pro uitvoerkwaliteit van frontierklasse voor $0,435/M in plaats van $5–$15/M.
Uitvoer Geleverd met Optionele Diepe Redenering
Het antwoord wordt samengesteld uit expertuitvoer en geretourneerd via jouw gekozen redeneermodus. Non-Think voor directe antwoorden. Think High voor stapsgewijze redeneringsketens. Think Max voor probleemoplossing met maximale diepte. Één model, drie kosten-kwaliteitsoperatiepunten — jij bepaalt de afweging per verzoek.
Het Open-Sourcevoordeel
Waarom de MIT-licentie alles verandert voor AI-implementatie
Wat DeepSeek V4 Pro Onderscheidt
30× Goedkoper dan Vergelijkbare Gesloten Modellen
Voor $0,435/M invoertokens kost DeepSeek V4 Pro 11× minder dan GPT-5.5 ($5/M) en 34× minder dan Claude Opus 4.8 ($15/M). Met promptcaching voor $0,003625/M benaderen werklasten met herhaalde context nagenoeg nulkosten. Een productiepipeline die dagelijks 10 miljoen uitvoertokens verwerkt, kost $261/maand op DeepSeek versus $7.500/maand op Claude. Hetzelfde budget dat één use case dekte, kan nu dertig use cases financieren.
MIT-licentie — Het Enige Echt Vrije Frontiermodel
Open-source AI bestaat al jaren, maar geen open-gewichtenmodel had de frontier-benchmarks van gesloten modellen geëvenaard — totdat DeepSeek V4 Pro verscheen. De MIT-licentie verwijdert alle commerciële beperkingen: bouw producten, implementeer op elke schaal, fine-tune vrij en behoud jouw afgeleiden. Het is de meest permissieve licentie gekoppeld aan het meest capabele open-gewichtenmodel ooit uitgebracht.
1,6T MoE — Diep Zonder Duur
1,6 biljoen parameters bieden encyclopedische wereldkennis over code, wetenschap, wiskunde en taal. Slechts 49 miljard worden geactiveerd per inferentie — overeenkomend met de rekenvoetafdruk van een middelgroot dense model. Manifold-beperkte hyperverbindingen en hybride KV-cachearchitectuur zorgen ervoor dat deze 49 miljard actieve parameters veel beter presteren dan hun omvang doet vermoeden. Je krijgt uitvoerkwaliteit van frontierklasse zonder inferentiekosten van frontierklasse.
Getraind op Huawei Ascend — Eerste Non-Nvidia Frontier
DeepSeek V4 Pro werd uitsluitend getraind op Huawei Ascend 950 en Cambricon AI-accelerators. Het is het eerste geverifieerde frontiermodel dat is getraind zonder één Nvidia GPU. Dit bewijst dat onafhankelijkheid van de AI-toeleveringsketen niet langer theoretisch is — een team dat buiten het Nvidia-ecosysteem opereert, heeft modellen geëvenaard of overtroffen die zijn getraind op de duurste GPU-clusters ter wereld.
Benchmarkprestaties
DeepSeek V4 Pro bij evaluaties voor programmeren, redeneren, wiskunde en wetenschap
Wie DeepSeek V4 Pro Gebruikt — en Hoe
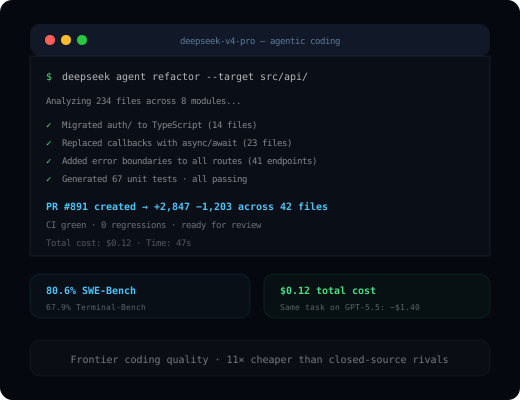
Autonomous Coding Agents
80,6% op SWE-Bench, 67,9% op Terminal-Bench. Bouw CI/CD-automatisering en meerstapse debuggingagenten op schaal. Dezelfde taak die $1,40 kost op GPT-5.5 draait hier voor $0,12.
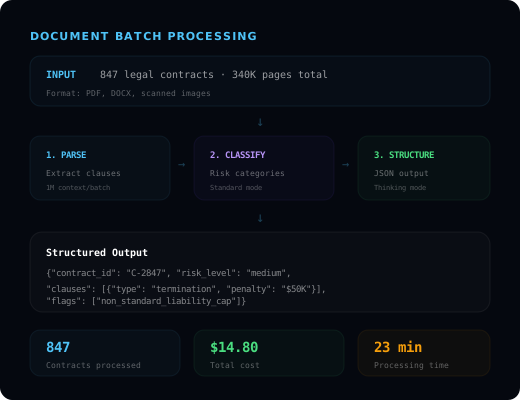
Document Analysis at Scale
847 contracten in 23 minuten voor $14,80. 1M tokencontext — volledige documentbibliotheken in één keer. Geen chunking, geen RAG-complexiteit. Parsen, classificeren, structureren — alles in één pipeline.
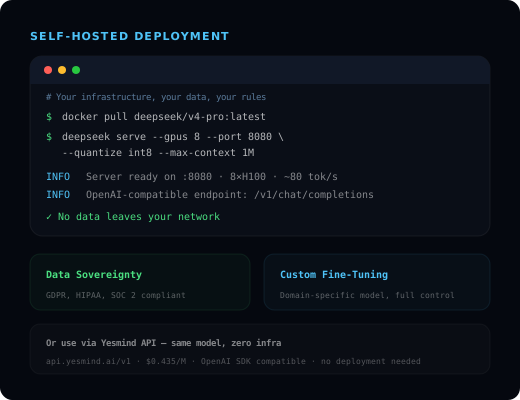
Self-Hosted Enterprise AI
MIT-licentie — implementeer op jouw infrastructuur, prompts verlaten jouw netwerk nooit. GDPR, HIPAA, SOC 2 conform door ontwerp. Fine-tune op propriëtaire data. Of gebruik het via de Yesmind API — geen installatie vereist.
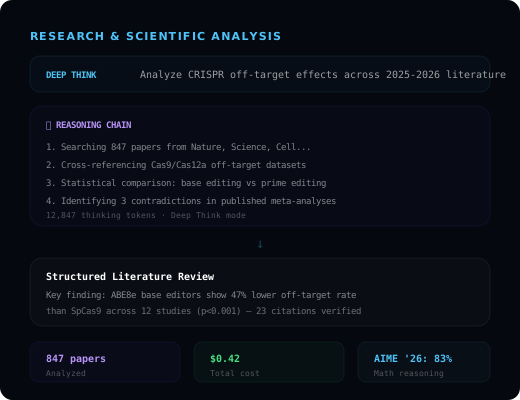
Research & Scientific Analysis
Deep Think-modus voor redenering op promotieniveau. GPQA Diamond bovenste tier, AIME '26: 83%, Codeforces Grandmaster (3.206). Meerstapse afleidingen voor $0,42 per analyse.
3 Redeneermodi — Één Model
Stem kosten, snelheid en diepgang per verzoek af zonder van model te wisselen